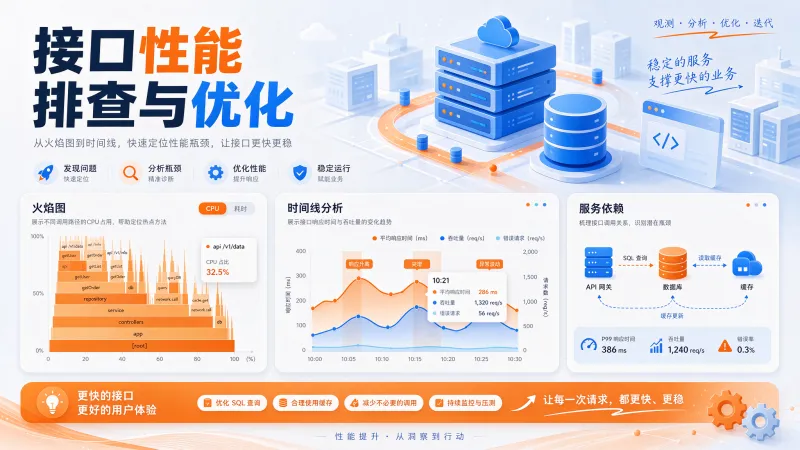
上周五下午三点,监控开始报警。
一个核心接口的 P95 响应时间,从平时的 42ms 涨到了 1.8 秒。P99 更夸张,直接到了 6 秒多。
报警来源是前端埋点:用户点击"提交订单"之后,要等很久才有反馈。但诡异的是,这个接口的代码没有任何改动,服务器负载也不高(CPU 24%,内存正常)。
这种"没改代码、负载也不高,但接口就是慢了"的问题,是最难查的一种。因为所有显眼的地方都正常。
整整查了七个多小时,最后定位到一个我们完全没想到的地方。今天把整个过程记下来。
第一步:先别猜,先量化
周五下午刚发现报警的时候,我第一反应是"大概是数据库慢了吧"。如果直接按这个猜想往下查,很可能查错方向。
所以先做了一件事:把接口的耗时按阶段拆开。
这个接口的调用链是这样的:
前端 → API 网关 → 控制器 → (读缓存 / 查数据库 / 调用第三方)→ 序列化 → 返回
我在每个阶段之间加了耗时打点(临时日志,只用了半小时),跑了一天,收了 47 万条样本。结果是这样:
| 阶段 | P50 | P95 | P99 |
|---|---|---|---|
| API 网关 | 1ms | 2ms | 4ms |
| 控制器入口 | 0.2ms | 0.5ms | 1ms |
| 读缓存 | 2ms | 8ms | 22ms |
| 查数据库 | 18ms | 96ms | 5840ms |
| 序列化返回 | 3ms | 6ms | 12ms |
一眼就看出来了:问题在"查数据库"这一段。P99 是 5.84 秒,而 P95 只有 96ms。
这个分布很关键。P95 和 P99 差了 60 倍,说明不是"所有请求都慢了一点",而是少数请求慢得非常离谱。
如果是全表扫描之类的问题,P50 也会跟着涨。但 P50 只有 18ms,说明绝大多数查询是好的。
所以问题是:少部分特定条件下的查询,走了完全不同的执行计划。
第二步:慢查询日志
既然定位到数据库,接下来就是查慢查询日志。
MySQL 的慢查询日志默认阈值是 10 秒,太宽了,我们改成了 500ms:
SET GLOBAL long_query_time = 0.5;
SET GLOBAL slow_query_log = ON;
SET GLOBAL slow_query_log_file = '/var/log/mysql/slow.log';
开了半小时,日志里攒了 3800 多条慢查询。
用 mysqldumpslow 聚合:
mysqldumpslow -s t -t 10 /var/log/mysql/slow.log排第一的是这条:
SELECT id, user_id, status, amount, created_at
FROM blog_orders
WHERE user_id = ?
  AND status IN (0, 1, 2)
  AND created_at >= ?
ORDER BY created_at DESC
LIMIT 20
平均耗时 4.2 秒,最大 8.1 秒,出现了 1200 多次。
表上其实是有索引的:
KEY idx_user_status (user_id, status)
KEY idx_created (created_at)
那为什么还慢?
第三步:EXPLAIN 揭示了真相
EXPLAIN SELECT ... 结果:
type: range
key: idx_user_status
rows: 12480
Extra: Using index condition; Using where; Using filesort
关键在最后那个 Using filesort。
它选用了 idx_user_status (user_id, status) 这个索引,走了 12480 行,然后把这 12480 行全部拿出来,在内存(或者磁盘)里做排序。
问题就出在这:排序字段 created_at 不在索引里,所以 MySQL 必须先取出所有匹配的行,再排序,再取前 20 条。
12480 行 × 每行取出 + 排序,就是 4 秒。
更糟的是,如果这个用户订单特别多(比如某些做批发的大客户,有几十万单),那个 filesort 就会溢出到磁盘,耗时直接上天。这解释了为什么 P99 会到 5.8 秒——那批请求对应的都是订单量极大的用户。
第四步:为什么"平时不慢"
这里是整个排查中最绕的一段。
同样的 SQL,同样的索引,为什么平时 P95 只有 96ms?
答案在参数分布的差异。
对于一个只有几十单的用户,这个查询只需要取出几十行,排序完取 20 条,快得很。
但对于一个有几万单的用户,它要取出几万行再排序。
而恰恰上周五,我们做了一次老客户回访活动,一批大客户集中回来查历史订单。于是 moisture 这类"极端参数"的请求比例,半天内从 0.3% 涨到了 4%。
4% 的慢请求,就足以把 P95、P99 全部拉爆。
这是一个很典型的教训:平均值和中位数看不出这类问题,只有看长尾(P95/P99)才能发现。
如果只看"平均响应时间",那天全天的平均值只从 38ms 涨到了 61ms,看起来完全不像事故。
第五步:火焰图看到了什么
数据库那边定位清楚了,但我想验证"接口层有没有别的问题"。于是用 strace + 简单的采样做了个火焰图。
这里说清楚,我用的不是专业工具(服务器上没装 perf),而是用 strace -c -p 挂了 30 秒,看系统调用的耗时分布。
结果很有意思:
84% 的时间花在了 poll 上——也就是在等数据库返回。
7% 在 fsync——写日志。
4% 在 sendto——发响应。
也就是说:PHP 进程本身没在算,全部在等。
这排除了"PHP 代码有死循环""内存不足导致 swap"这些可能。
火焰图在这里的作用不是"找到问题",而是"排除嫌疑"。它让我确认:不用去改 PHP 代码,不用加内存,问题就是数据库的。
这一点很重要。很多排查之所以绕远路,就是因为一开始没做"排除",在错误的方向上花了两天。
第六步:怎么修
定位清楚之后,方案就有三个:
方案 A:加索引 (user_id, status, created_at)
这是最直接的。把 created_at 也放进索引,MySQL 就能直接从索引里按顺序取 20 条,不需要 filesort。
用 MySQL 的复合索引"最左前缀"原则,(user_id, status, created_at) 能满足:
- WHERE user_id = ?
- WHERE user_id = ? AND status = ?
- WHERE user_id = ? AND status = ? ORDER BY created_at
方案 B:分页优化
如果用户看的是前 20 条,可以让"取 20 条"这件事更便宜——比如用 ORDER BY id DESC 代替 created_at DESC(如果 id 是自增的,通常顺序一致)。这样可以让 MySQL 用主键索引反向扫描。
方案 C:限制查询范围
比如只允许查最近 6 个月的订单,更早的走另一个接口(或者直接归档)。
我最后选了 A + C:
1. 加了复合索引 (user_id, status, created_at DESC)(MySQL 8.0 支持降序索引)
2. 接口层限制了查询窗口:默认只看 90 天,要看更早的必须显式传参
为什么不做 B?因为 id 和 created_at 的顺序在实践中不保证一致(有补录数据的场景),不能依赖。
改完之后的数据
| 指标 | 修复前 | 修复后 |
|---|---|---|
| 该 SQL 平均耗时 | 4.2 秒 | 11ms |
| 该 SQL 最大耗时 | 8.1 秒 | 38ms |
| 接口 P50 | 38ms | 26ms |
| 接口 P95 | 1.8 秒 | 54ms |
| 接口 P99 | 6.2 秒 | 88ms |
| EXPLAIN 的 Extra | Using filesort | Using index |
P99 从 6.2 秒降到 88ms。整个接口的耗时曲线,从"长尾拖到 6 秒"变成了"全部集中在 100ms 以内"。
副作用是:多了一个索引,写入时多维护一份。实测插入订单的耗时从 3.1ms 涨到 4.4ms。这个代价可以接受。
几点体会
1. 不要相信"平均值"。
这次事故里,全天平均响应时间只从 38ms 涨到 61ms。如果只看这个数字,会觉得"稍微慢了点,问题不大"。但实际是有一批用户在等 6 秒。
平均值会掩盖极端值,而用户体验恰恰由极端值决定。一个人的订单提交等 6 秒,他就不会再点了。
2. 有索引不等于不慢。
这次的表上有两个索引,都"用上了"(EXPLAIN 的 key 不是 NULL)。但它仍然慢,因为索引只能加速"找到行",不能加速"排序"。
很多人查慢查询的时候,看到 key 不是 NULL 就放心了。这是错的。一定要看 Extra,尤其要看有没有 Using filesort 和 Using temporary。
3. 参数分布比索引更重要。
同一个 SQL、同一套索引,在小用户上跑 20ms,在大用户上跑 6 秒。这不是索引的问题,是数据倾斜的问题。
所以优化不能只测"随便一个用户",要测"订单最多的那个用户"。我在压测环境里加了一个"极端用户"的数据集(10 万单),专门测这种场景。
4. 火焰图的价值有时是"排除"而不是"发现"。
这次火焰图并没有直接告诉我问题在哪,但它告诉我"不在 PHP 里"。这种"排除"往往比"发现"更有价值,因为它能让你尽早停止错误方向的探索。
5. 监控要盯长尾,不要盯均值。
这次之后,我把所有核心接口的报警阈值都改成了基于 P95 和 P99。均值报警改成"参考指标",不触发告警。
写在最后
这次的排查过程,七个多小时,其实真正"找到问题"的时间只有最后半小时。前面六个多小时,都在做两件事:量化,和排除。
周五晚上十点多,我改完索引、验证完数据,坐在工位上想了一会儿。
我意识到这次能查出来,有一点运气成分——如果不是下午刚好做了老客户回访活动,如果不是那批大客户集中查订单,这个 P99 的问题可能还要潜伏好久。等到某天某个大客户查订单,等 6 秒,然后投诉。
所以这次事后,我加了两件事:
第一,在测试环境造了一批"极端数据"(订单量极大的用户),每次发版前跑一遍核心接口,看 P99。
第二,把所有 ORDER BY 配合 LIMIT 的查询都过了一遍,检查有没有 filesort。
第二个检查一共查出 17 处。目前改了 9 处,剩下 8 处排进了下个版本。
慢查询不是一个"修完就没了"的问题,它是一个需要持续盯的习惯。
评论(0)
暂无评论,快来抢沙发~
评论功能仅对会员开放,请先登录
登录